DeepSeek Flash 更新后,搜索的钱要单独算
Flash 1017 沿用原来的 API 名称与 token 单价,但搜索和网页抓取有自己的计费与限流。做资料助手时,应把模型回答、找资料和读网页分别验收。
文章目录
模型单价没变,资料助手的预算可以不动吗?#
假设一个资料助手每天替用户查行业消息、打开原始公告,再整理成带来源的摘要。模型供应商发布更新,说回答更精简、完成任务更快,原来的调用方式和单价都不变。产品团队很容易得出一个判断:接下来应该更省了。
我会先拆开看。这项工作至少包含三件事:模型理解与写作,搜索找到候选页面,抓取读到网页内容。它们可以出现在同一次对话里,却未必使用同一种计费单位,也未必共享同一个容量上限。
DeepSeek 在 2026 年 10 月 17 日发布 DeepSeek-V4.1-Flash-1017,同时开放 Search / Fetch API。这组更新值得关注的,不只是模型多拿了几分,而是资料助手的成本与等待需要重新分账。官方更新记录
名字没换,背后的模型已经更新#
官方说明,deepseek-flash 已升级到 1017,API 调用方式和 token 价格保持不变。当前价格页还注明,旧名称 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 也指向这一版本。这个范围只涉及这些 Flash 名称,不能扩大成所有 DeepSeek 模型。当前模型与价格
Token 是模型计量输入输出的单位,与汉字并非一一对应。单价不变,意味着每个计费单位的价格没有因此调整;最终用了多少单位,仍取决于任务怎么执行。
DeepSeek 称,本次更新减少输出长度和任务执行时间。但发布说明没有给出统一的缩短比例,也没有据此证明任意业务都会更快,更不能直接推成首字响应时间降低。对于资料助手,我会检查更短的摘要有没有保留结论、来源和重要限制,而不是把少写字本身当作完成质量。
评测提升提供了候选依据,没有替我们算业务账#
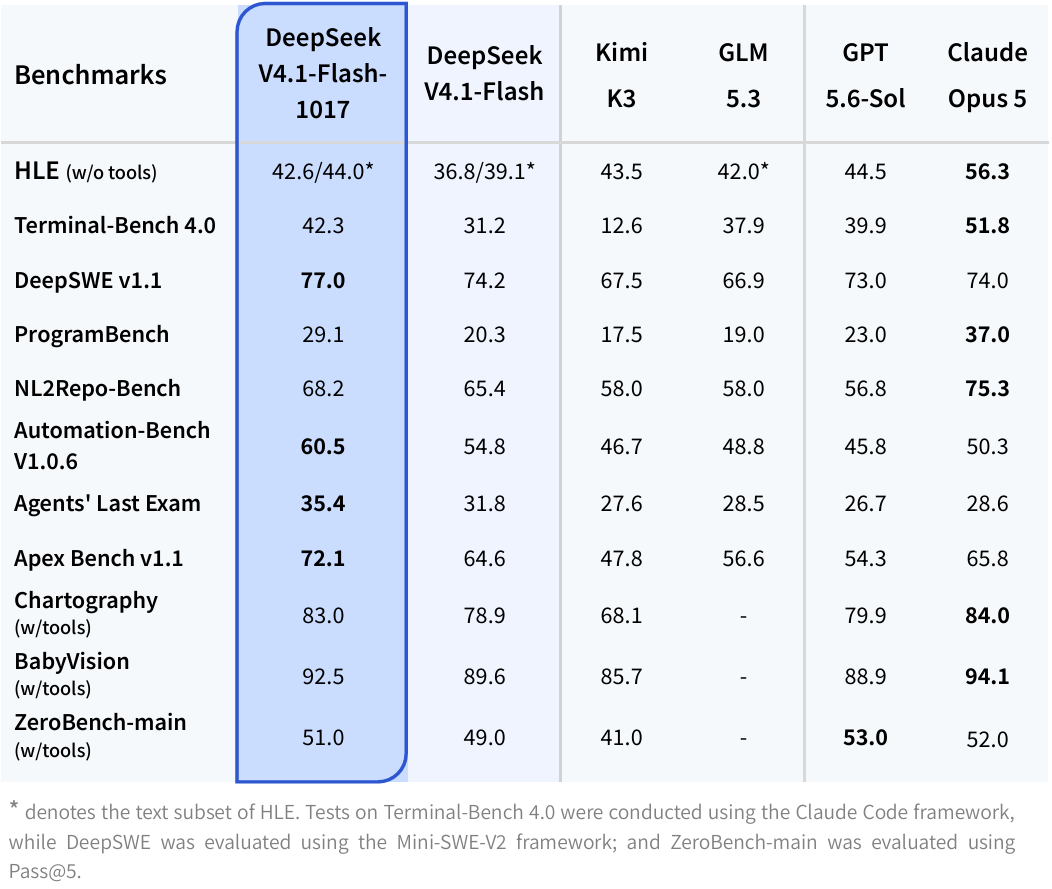
官方模型卡给出上一版 V4.1 Flash 与 1017 的对照。以下保留三项与复杂任务有关的成绩,均为供应商报告的分数,越高越好。
| 评测 | 上一版 V4.1 Flash | Flash 1017 | 阅读时要带上的条件 |
|---|---|---|---|
| HLE,无工具 | 36.8 | 42.6 | 通用高难度问答,不是联网资料核验 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | 使用 Claude Code 的终端任务设置 |
| DeepSWE v1.1 | 74.2 | 77.0 | 使用 Mini-SWE-V2 的软件工程设置 |
来源为官方模型卡与官方评测表。这些任务和工具配置不同,不能把三行合成一个“整体提升百分比”。汇总材料也没有完整展开每项重复次数、置信区间与全部预算条件;本文没有复现。
发布页另有性能与成本图,采用 DeepSWE v1.1、Mini-SWE-V2、Pass@1,即一次尝试的通过表现,横轴是每项任务的平均美元成本。它仍然是在特定编程任务里比较。图下注明的公开榜单数据日期为 2026 年 9 月 22 日,不能把所有竞争模型的点都当作同日重跑,更不能从图上目测出自己的资料助手会省多少钱。原图与条件
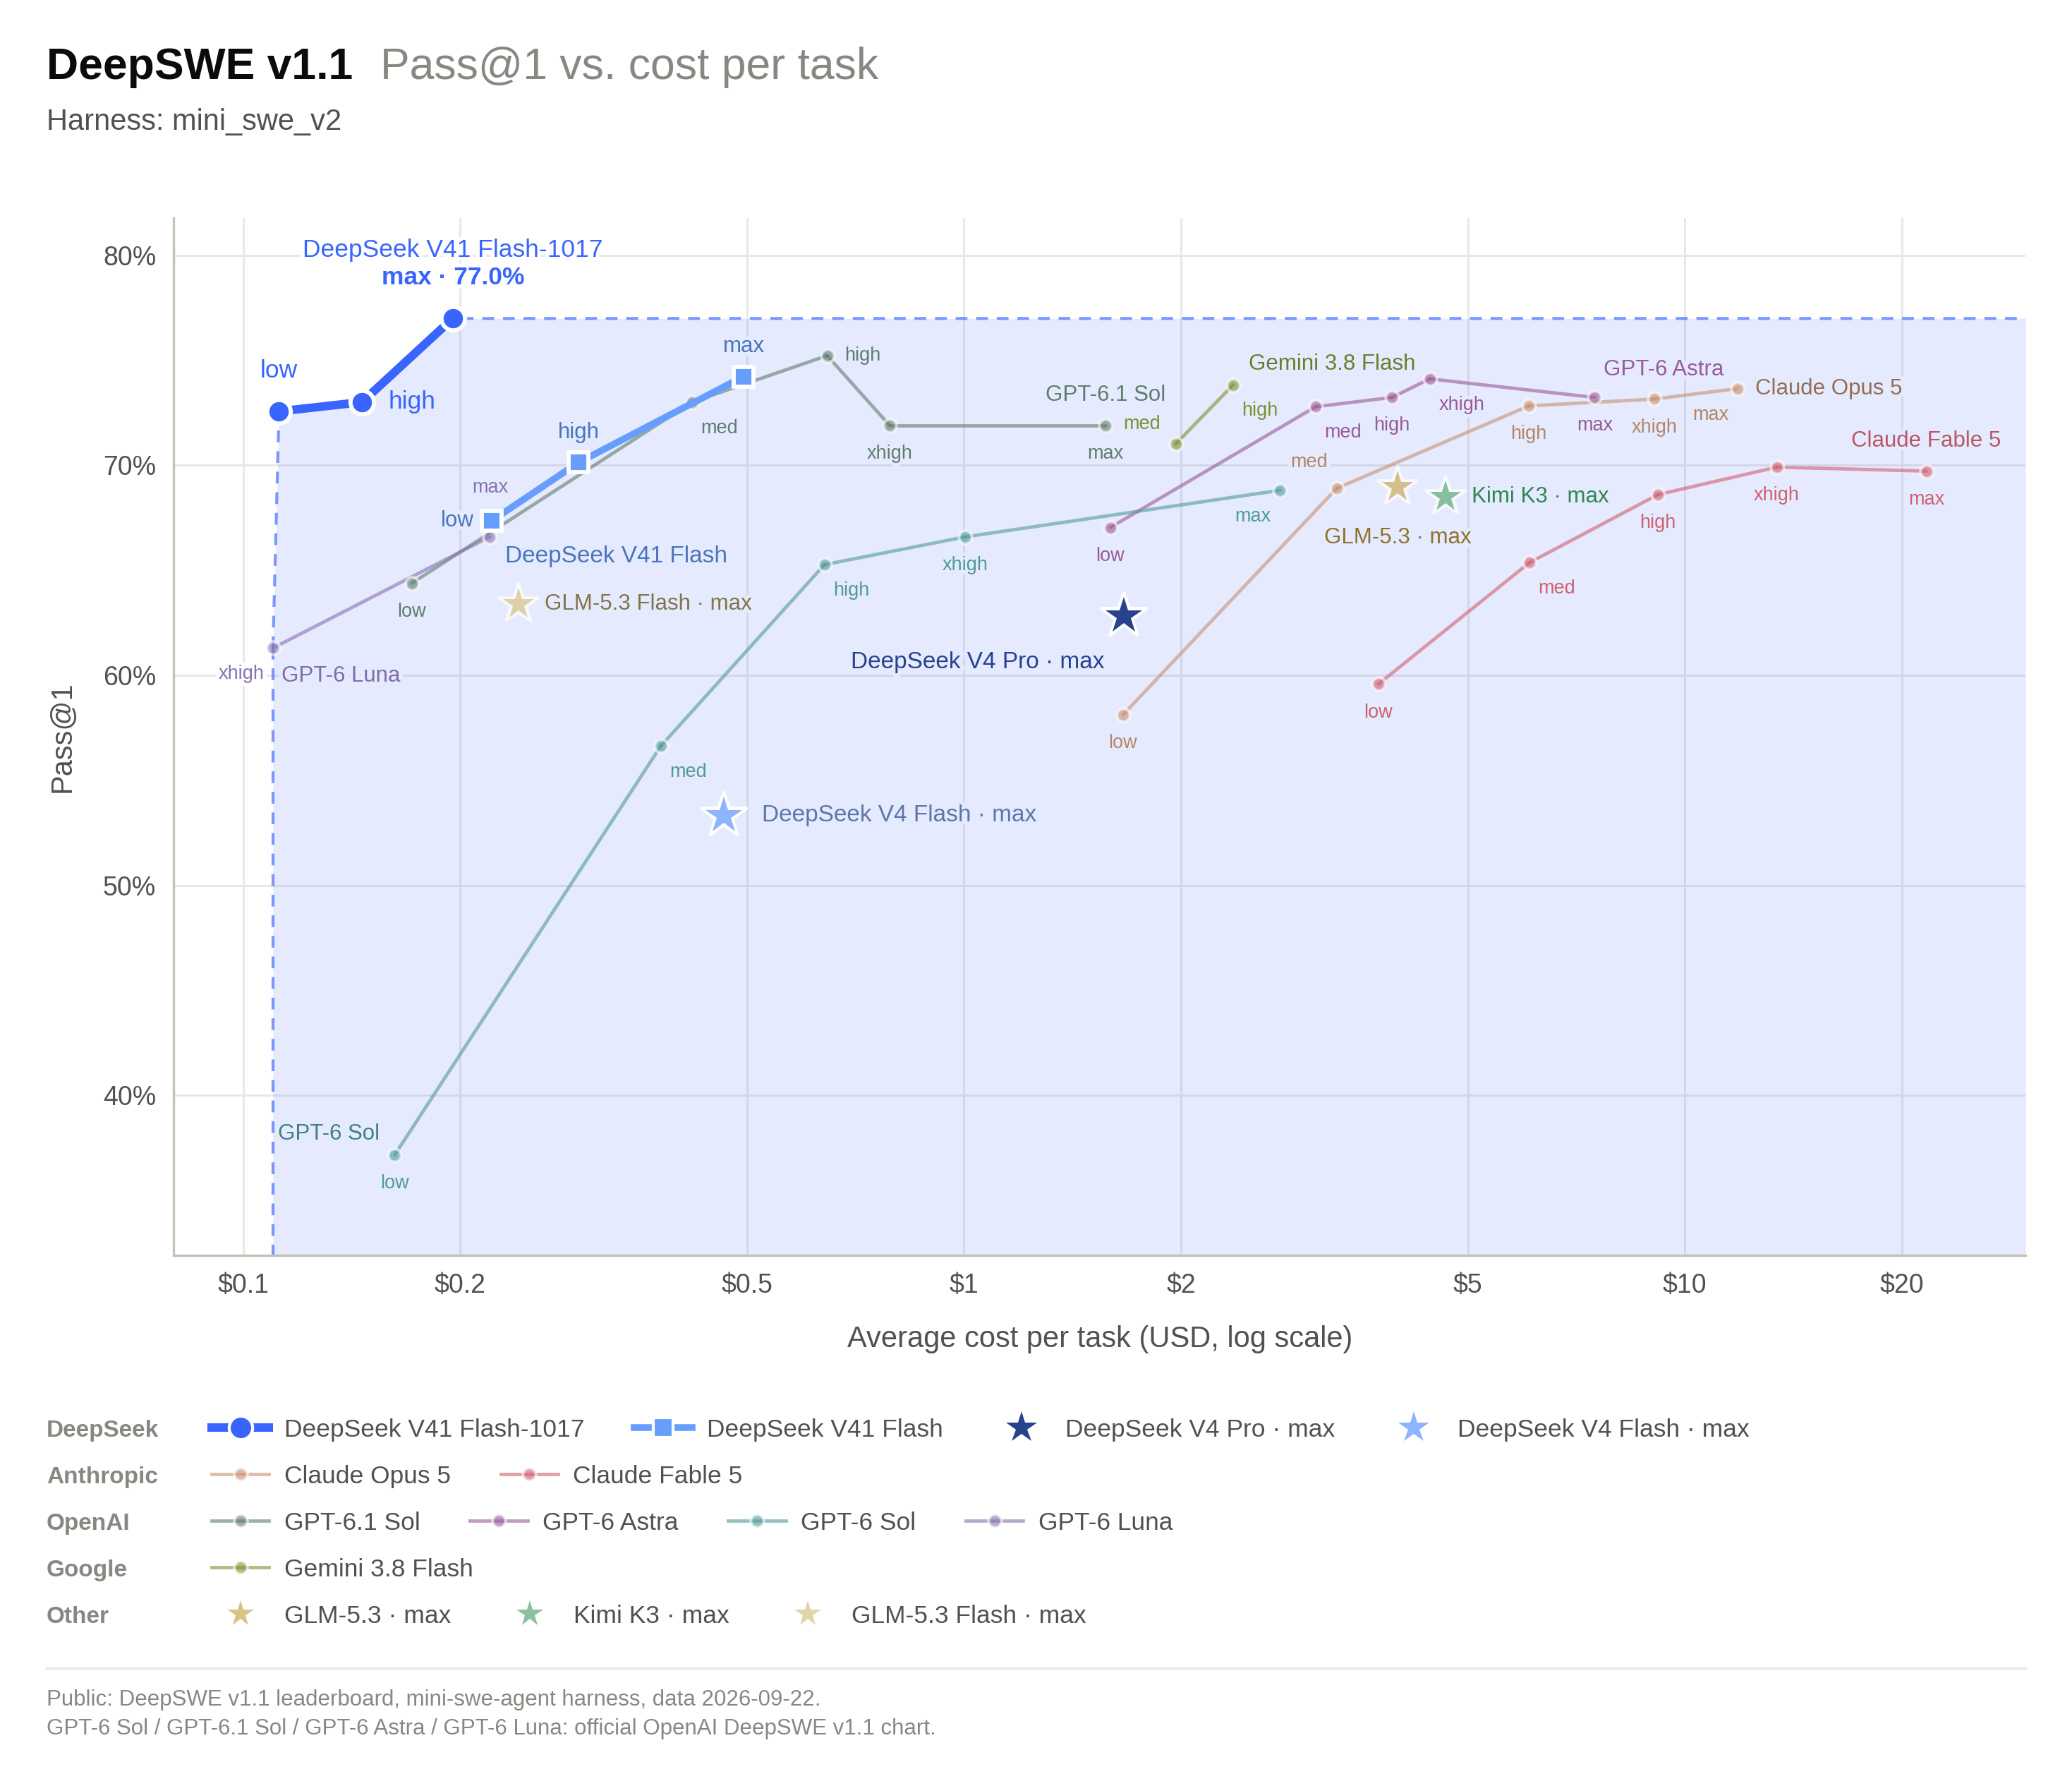
这组成绩支持把新版纳入验证。业务账单还要回到实际工作过程。
一次搜索和一次读网页,是两笔账#
Search 用来寻找网页,Fetch 用来读取某一个网页并返回 Markdown 文本。官方文档给出的价格分别是:
- Search:每 1,000 次成功请求 0.75 美元。
- Fetch:每 1,000 次成功请求 0.75 美元。
这里数的是成功请求,不是返回了多少条结果,也不是模型用了多少 tokens。计费还要求请求返回成功状态并产生结果:搜索结果列表非空,或抓取确实取得页面内容。空搜索、失败和超时不收费。计费规则
举一个纯计算示例:如果一份摘要用了 2 次成功搜索和 4 次成功抓取,按上述单价,工具费用合计是 0.0045 美元。这不是一次实测,也不是完整任务成本;模型阅读材料与生成答案的费用、其他服务和人工复核都没有算进去。
文档还区分了使用渠道:通过 DeepSeek Harness、Claude Code 或 Codex 使用 DeepSeek API 时,已有的服务端搜索与抓取调用目前免费,将从北京时间 2026 年 11 月 1 日零点开始按次计费。不能把这段免费期套到所有直接调用 Search / Fetch API 的请求上。
这意味着,试点阶段账单很低,也可能包含暂时免费的工具。如果产品准备在免费期结束后扩大使用,就应该按届时的规则估算,而不是把今天的账单直接乘上用户数。
多找几条结果,不一定要多搜一次#
Search 的结果数量默认是 10 条,可以设为 1 到 50 条。调整这个数量,不改变单次请求价格。这个细节会影响产品设计,但不意味着每次都应该取满。
候选结果越多,模型可能需要读更多材料,里面也可能混入重复或不相关内容。我的建议是先明确用户需要回答什么,再判断缺的是候选来源、某页原文,还是已经足够但没有及时停止。
例如,写一则产品更新摘要,已有官方公告可以确认发布日期与开放范围,就没有必要为了“多看几个网站”反复搜索。若公告缺少价格,再定向查价格页。若来源互相矛盾,应继续核验或明确标出分歧,不能为了少花一次工具费省掉关键证据。
我会让试点记录保留这三类消耗,并额外标出重复搜索、重复读同一页面和最后仍缺失的证据。这样才能判断钱花在补齐信息,还是花在原地绕圈。本文没有验证某种停止规则能带来固定节省比例。
免费失败也会占用用户的时间#
Search 和 Fetch 分别限制为每个账户每秒 5 次请求,二者独立计算;同一账户换不同 API key 不会获得独立额度。Fetch 还有按目标域名计算的限制,文档未给出统一数值。这些限制与模型并发上限分开。限流与错误说明
所以,即使模型并发容量足够,也不代表搜索和抓取能同步放大。资料助手在用户集中提问时,可能卡在找资料这一段。这里的每秒请求数也不能直接换算成能服务多少用户,因为每项任务需要的调用数量和节奏不同。
我会把排队等待、工具失败与模型生成分开观察。网页不可读时,产品应说明哪项证据没有取得;因限流暂时失败时,可以按规则等待重试,但要有次数和总等待上限。不能因为失败不收费,就让用户无限等下去。
抓取仍受目标网站可用性与访问政策约束。Search / Fetch 也没有消除外部网页带来的错误信息或提示注入风险。查到内容,只是拿到了待判断的材料,不等于获得新的操作权限。
先验收完整任务,再决定怎么放量#
对于前面的资料助手,我会用同一批问题,固定资料时效要求与交付标准,检查新版能否给出可追溯的结论。同时记录模型消耗、两类成功工具请求、总等待和人工补查量;免费期内的调用,也按未来计费规则单独估算。
如果摘要更短、关键证据齐全,而且没有增加绕圈与补查,就有理由逐步扩大使用。若只是输出少了,却把核验工作交回用户,成本并没有真正消失。
本次更新给我的产品提醒很具体:模型单价是一部分,搜索规则是一部分,用户最后能否拿到可靠结果还需要单独验收。把这几件事拆开,预算才有解释力,出问题时也知道该改哪里。
来源与边界#
- 版本与发布日期: DeepSeek《DeepSeek-V4.1-Flash-1017 Release》及《更新记录》,2026 年 10 月 17 日。对象为 V4.1 Flash 的 1017 小版本更新,包含能力、输出与任务执行效率描述。没有给出适用于所有场景的延迟或输出降幅。
- 模型与评测: DeepSeek 官方《DeepSeek-V4.1-Flash-1017 模型卡》及上文两张官方评测图。本文选取无工具问答、终端和软件工程三类证据,保留各自工具设置。成绩来自厂商,不能直接映射为中文资料摘要的准确率或成本,也没有构成同一预算下的全面能力排名。
- 工具规则: DeepSeek《Search & Fetch》,2026 年 10 月 18 日读取;页面没有独立发布日期,开放消息与 10 月 17 日更新一起核对。依据包括两类工具的计费单位、成功条件、免费渠道结束时间与账户级限流。页面没有提供本文业务的完整延迟、来源核验正确率或安全评测。
- 当前映射: DeepSeek《Models & Pricing》,2026 年 10 月 18 日读取,独立发布日期未标注。仅用于确认 Flash 名称对应版本与价格规则;文档会更新,正式接入时应再次核对。
- 本文判断: 资料助手、分账方式、停止规则与放量建议是产品推导,未声称亲自运行模型或工具。0.0045 美元仅为明确假设下的工具费用计算。本文不把能力成绩、拒答行为、工具权限和人工治理混为同一种安全保证。